基因组学
从序列到功能,从DNA水准探索生命本质,助力基础 科研、育种及临床转化的突破。
动植物T2T基因组测序
T2T基因组(Telomere-to-Telomere)采用 PacBio HiFi 高精度长读长、ONT 超长读长与 Hi-C 等技术组合,实现一条或多条染色体从端粒到端粒的无缺口(gap)完整组装,解决传统基因组草图中端粒、着丝粒与核糖体 DNA 等复杂重复区域的序列缺失问题。目前已在水稻、拟南芥、葡萄及人类等物种中成功构建高质量 T2T 参考基因组,显著提升基因组连续性与基因注释完整性,为动植物生物学研究与育种实践提供全新视角。
原理介绍
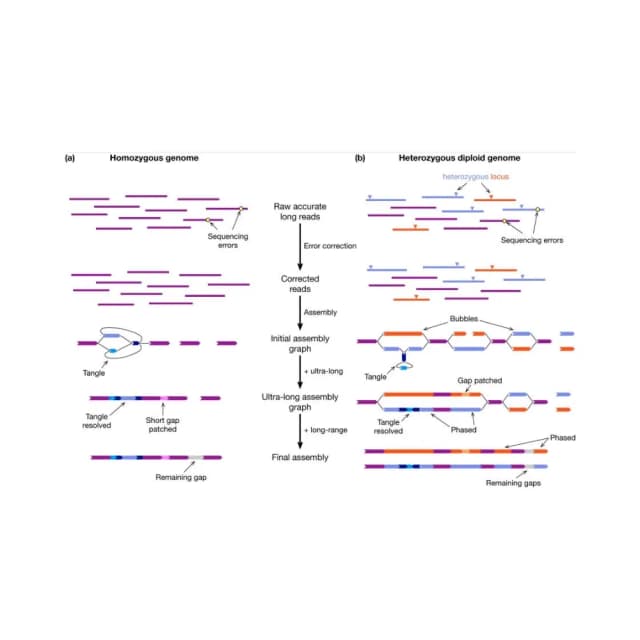
T2T(Telomere-to-Telomere)基因组是指通过多种测序手段、高深度测序序列组装,获得 0 gap 或近 0 gap 的高质量基因组。T2T 基因组克服了着丝粒及高重复区域的组装困难问题,染色体的连续性和完整性大大提高,有助于对基因组中高重复序列区域或高重复结构进行深入研究。测序策略采用 PacBio HiFi 与 Nanopore Ultra-long 双平台结合:HiFi 测序读长准确度高(reads N50 约 15 Kb,Q30 ≥ 75%),实现高保真组装;Nanopore Ultra-long reads 可达 Mb 级别,轻松跨越基因组高重复及高复杂区域。两种数据分别组装后经合并、纠错,并结合 Hi-C 数据挂载到染色体水平,完成高质量 T2T 基因组的构建。
实验流程
样本检测
对样本进行严格质量检测,确保样本质量满足后续DNA提取和测序要求,评估核酸浓度、纯度与完整性等各项指标是否达标,保障项目质量。
DNA 提取
采用合适方法从样本中提取高纯度、高完整性的基因组DNA,充分去除蛋白质与杂质,全面保障后续文库构建与测序的高质量,满足长读长测序要求。
文库构建
分别构建 PacBio HiFi 文库(高准确性、多次读取同一片段提升精度)与 ONT Ultra-long 文库(超长读长)
上机测序及质控
PacBio Revio 平台 HiFi 测序,Nanopore 平台 Ultra-long 测序,fastplong 质控统计
数据组装
hifiasm、NextDenovo 等软件组装,结合 Hi-C 辅助挂载至染色体水平,填补 gap 并对染色体末端进行端粒延伸
组装评估
从基因组大小、连续性(N50)、完整性(BUSCO)、一致性(二代回比)、QV值等维度评估组装质量,确保达到T2T标准,输出评估报告。
基因组注释
鉴定重复序列与ncRNA,经同源及从头预测、EVM整合与PASA更新获得基因结构,并进行GO/KEGG/InterPro功能注释,支撑后续研究
送样标准
动物组织、动物细胞、血液、植物样本、昆虫样本、海洋软体动物等。
动物组织 3×10^6 cells、动物细胞 3×10^6 cells、血液样本 2 mL、植物样本 2 g、昆虫样本 1 g;建库一次用量分别为 1×10^6 cells、1×10^6 cells、1 mL、300 mg、100 mg。
De novo 组装项目,单个个体可获取足量材料时建议从同一体取材制备各类型文库(PacBio、Illumina 小片段、ONT、Hi-C 等),且以相同组织部位最佳;单一个体不足时应确保各文库 DNA 来源同一混池,并尽量减少混合个体数量、保证亲缘关系接近。
添加 EDTA 抗凝剂(不接受其他抗凝剂),4℃ 保存并在采集后三天内寄送;无法保证则液氮速冻 30 min 后 -80℃ 保存,干冰运输。
建议细胞总量 ≥ 2.0×10^6 cells,冻存前活率 > 75%,使用含 20% FBS 与 10% DMSO 的冻存液,-80℃ 或液氮保存,干冰运输。
优先选取高细胞性低脂肪组织(血液 > 精子细胞 > 脾脏 > 心脏),液氮速冻 30 min,-80℃ 保存,干冰运输。
优先幼嫩活体组织,新鲜组织用无菌水冲洗 ≥ 3 次并吸干水分后收集于冻存管,液氮冷冻,-80℃ 保存,干冰运输。
发育阶段优先级为胚胎 > 新孵幼虫 > 早期蛹 > 成虫;液氮速冻前需饥饿处理数天,-80℃ 保存,干冰运输。
顺丰次日达或当日达,液氮速冻样本用足量干冰寄送,并附完整样本信息单。
交付内容
组装结果
T2T 级基因组序列 FASTA 文件、gap 填补与端粒修复结果、Hi-C 挂载染色体结果;
组装评估报告
基因组大小、Contig N50/Scaffold N50、BUSCO 完整性评估、二代数据回比一致性、QV 质量值评估表与图表;
重复序列注释结果
RepeatMasker 鉴定结果含 LTR/TIR/LINE/SINE 等转座子的分类统计表与分布图;
ncRNA 注释结果
基于 Infernal/Rfam 数据库注释的 miRNA、tRNA、rRNA、snRNA、snoRNA 序列与基因组位置信息表;
基因集
同源预测 + 从头预测 + EVM 整合 + PASA 更新后的基因结构注释 GFF3 文件;
基因功能注释
GO、KEGG、InterPro、SwissProt、NR 等数据库的功能注释结果表;
结题报告
含方法描述、结果图表与解读的 T2T 基因组注释分析完整 PDF 报告。
常见问题
主要从四个维度评估:组装连续性(N50)、组装完整性(BUSCO)、组装一致性(二代数据回比)以及 QV 质量值,高 QV 值意味着组装结果更可靠、错误率更低。
