基因组学
从序列到功能,从DNA水准探索生命本质,助力基础 科研、育种及临床转化的突破。
简化基因组测序
简化基因组测序(Reduced Representation Genome Sequencing,RRGS)是一类通过酶切、片段筛选或靶向富集等方式降低基因组复杂度,再对基因组中特定代表性区域进行高通量测序的技术。与全基因组重测序相比,简化基因组测序不追求覆盖整个基因组,而是以较低测序成本在全基因组范围内获得大量稳定、可重复的分子标记,尤其适合大基因组、重复序列比例高、群体样本量大或参考基因组不完善的动植物研究。 该技术可用于快速开发 SNP、InDel 等遗传标记,开展遗传图谱构建、QTL 定位、BSA 定位、群体遗传结构分析、遗传多样性评价、品种鉴定、亲缘关系分析、分子辅助育种和基因组选择等研究。常见技术类型包括 RAD-seq、ddRAD-seq、GBS、SLAF-seq 等,均属于“降低基因组复杂度后进行高通量测序”的技术体系。对于需要分析大量样本、但不需要获得全基因组所有变异信息的项目,简化基因组测序具有成本低、通量高、数据利用率高、分析效率高等优势。
原理介绍
简化基因组测序的核心逻辑是“基因组复杂度降低-特定片段测序-标记开发与分型”。首先提取样本基因组 DNA,选择合适的限制性内切酶对基因组进行酶切,使不同样本在相同酶切位点附近产生可重复的片段;随后在片段两端连接带有样本 Barcode 的测序接头,通过片段大小筛选、PCR 扩增和文库质控获得测序文库;最后利用 Illumina 等高通量测序平台进行测序。
文献案例
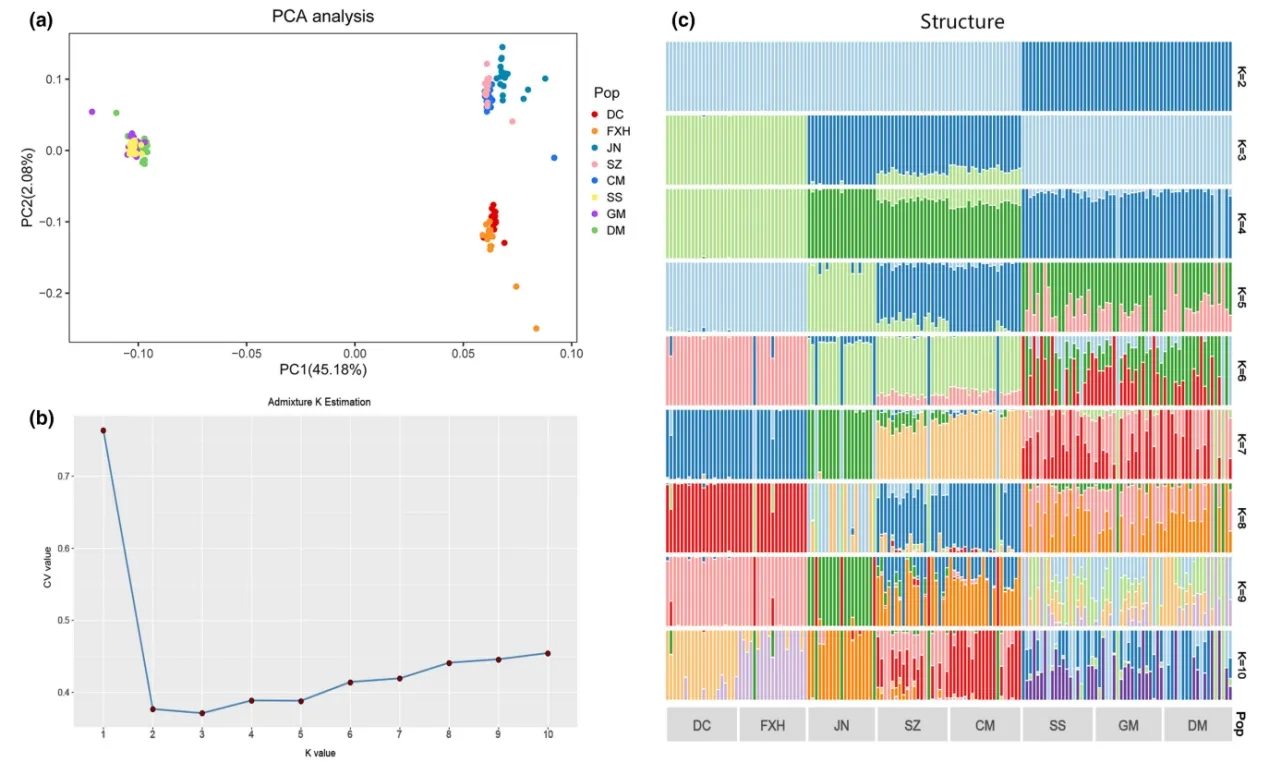
2022年,在Ecology and Evolution发表的题为“ddRAD‑Seq reveals evolutionary insights into population differentiation and the cryptic phylogeography of Hyporhamphus intermediusin Mainland China”的研究论文。该研究利用ddRAD-Seq简化基因组测序技术,对中国大陆间下鱵鱼(Hyporhamphus intermedius)8个地理群体的156个个体进行了全基因组水平的SNP分型,成功筛选出5498个高质量位点。结果显示,该物种存在显著的南-北-高原三相遗传结构,南方群体与北方群体间已发生高度分化(FST > 0.3),且云南高原引入种群的遗传背景更接近于北方长江流域群体;环境关联分析(GEA)进一步揭示溶解氧和温度是驱动其局域适应的关键因子,表明地理隔离与环境异质性共同塑造了该物种的隐存谱系分化与种群演化历史。
实验流程
基因组DNA提取与质检
提取样本基因组DNA,经琼脂糖凝胶电泳与分光光度法检测浓度、纯度及完整性,并采用Qubit荧光准确定量,确保质量满足酶切建库要求。
基因组DNA酶切处理
依据物种与基因组大小科学设计酶切方案,选用适宜的限制性内切酶完成酶切消化,经磁珠筛选回收特定大小范围内的酶切片段用于建库,保证文库代表性。
建库修饰与片段筛选
为酶切片段连接含样本标签(barcode)与测序接头,经严格磁珠筛选去除过短或过长的非目标片段,最终获得大小集中、结构合格的目标测序文库。
文库扩增纯化与质检
对连接产物进行PCR扩增以增加文库产量,采用磁珠纯化有效去除引物二聚体等杂质,并通过Qubit、qPCR及电泳全面检测文库质量。
高通量上机测序
将质检合格的文库按等量混合上机,于Illumina高通量测序平台进行双端测序,获取足量高质量的原始下机数据(raw reads)。
测序数据质控与比对
对原始下机数据进行去接头、质量过滤与样本拆分,将洁净reads比对至参考基因组并进行序列聚类与SNP标记识别,确保数据可靠。
变异检测与基因型过滤
基于高质量比对结果开展SNP/InDel变异检测,设置最小深度与基因型质量阈值进行严格过滤,最终完成各位点的精准分型与基因型填补。
遗传分析与基因注释
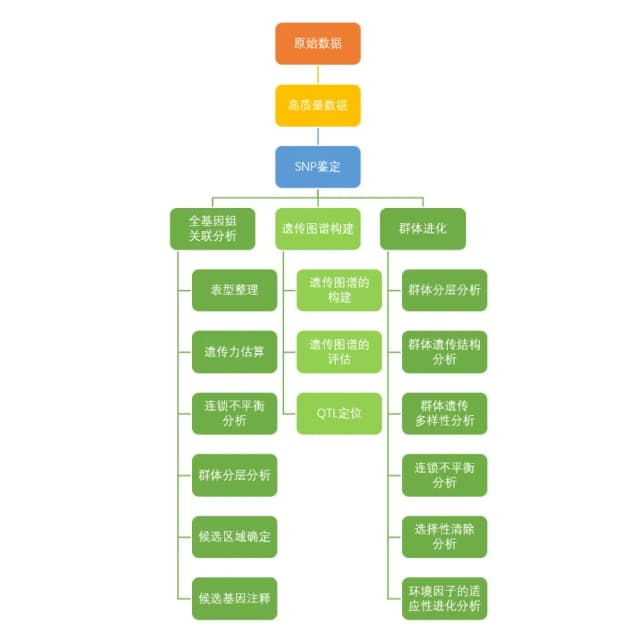
开展全面的群体遗传学分析(如群体结构、连锁不平衡与遗传多样性),深入结合基因功能数据库对候选区域进行注释与功能富集解读,支撑后续研究。
送样标准
总量≥0.5 μg,推荐≥1 μg
≥20 ng/μL
OD260/280=1.8-2.0,OD260/230≥1.8
无明显降解,主带清晰
≥25 mg
≥200 mg
≥0.6 mL
≥0.1 mL
建议提前沟通评估
交付内容
标准分析结果
1) 数据质控报告:统计原始数据量、Clean Data 数据量、Q20、Q30、GC 含量、接头污染和低质量序列过滤情况。 2) 样本拆分结果:根据 Barcode 信息将混合测序数据拆分到各个样本,并统计各样本数据量和有效 Reads 比例。 3) 标签聚类或参考基因组比对结果:有参考基因组时提供比对率、覆盖情况等统计;无参考基因组时提供标签聚类结果。 4) 变异检测与过滤:检测 SNP/InDel 位点,并按照测序深度、缺失率、等位基因频率等指标进行质量过滤。 5) 基因型分型结果:提供各样本在高质量标记位点上的基因型矩阵,便于后续遗传分析。
分析与个性化结果
遗传图谱构建:提供标记分组、遗传距离、连锁图谱和标记分布结果。 QTL 定位或 BSA 分析:定位与目标性状相关的候选区间,并结合基因注释筛选候选基因。 群体遗传学分析:包括 PCA、系统发育树、群体结构、遗传多样性、Fst 和亲缘关系分析等。 GWAS 分析:结合表型数据进行全基因组关联分析,筛选与目标性状相关的显著位点和候选基因。
可视化结果
变异文件:以 VCF 等标准格式存储变异位点信息。 基因型矩阵:提供适用于遗传分析软件的格式化文件。 可视化图表:包括 SNP 密度图、样本聚类图、PCA 图、群体结构图、系统发育树、遗传图谱、QTL 定位图、BSA 关联图和 GWAS 曼哈顿图等。
常见问题
可以。没有参考基因组时,可通过标签序列聚类构建参考标签,并基于共有标签进行 SNP 开发和基因型分型。但如果研究目标涉及候选基因注释、候选区域精确定位或与基因组位置相关的分析,有高质量参考基因组会显著提高结果解释能力。
主要有覆盖率和覆盖深度。覆盖率是指测序得到的碱基占全基因组的比例。覆盖深度是指单个碱基被测到的平均次数。覆盖率可以反映出分子标记是否有代表性,覆盖深度决定了分子标记的检测的准确度。
有参考基因组的物种获得的SNP的准确性更高。
要求分子标签在全基因上均匀分布,在不同的个体之间有特异性等。同时,根据不同的研究目的,对分子标签的密度要求也有所不同。
