基因组学
从序列到功能,从DNA水准探索生命本质,助力基础 科研、育种及临床转化的突破。
全基因组测序 (WGS)
人全基因组重测序(Whole-genome sequencing,WGS)是基于人基因组参考序列对个体或群体进行全基因组测序(resequencing),并在个体或群体水平筛选出基因组范围内的遗传变异,实现基因型多样性分析、遗传进化分析,致病和易感性基因,单基因病筛查以及癌症筛查等的筛选。随着二代测序(Illumina)技术的发展与普及,全基因组重测序已成为人类遗传学、转化医学和群体进化领域最为迅速而有效的方法之一,可更全面地挖掘全基因组范围内的序列差异和结构变异,包括单碱基突变、插入缺失变异、拷贝数变异和结构变异(SNV、SNP、InDel、CNV、SV),在全基因组水平上扫描并检测与表型差异、疾病、进化等相关的突变位点。
原理介绍
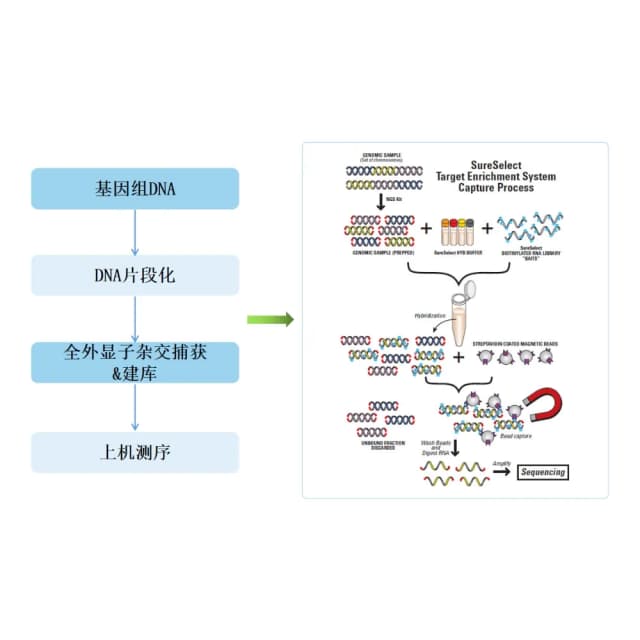
文库构建:DNA随机打断后连接测序接头,扩增形成文库。 测序:基于边合成边测序(Sequencing-by-Synthesis)原理,生成短读长序列(如Illumina的150 bp)。 比对:将测序数据与参考基因组(如GRCh38)比对,识别变异位点。 变异检测:通过GATK、Samtools等工具检测SNP、InDel、SV/CNV。 注释与分析:结合功能数据库(如ClinVar、dbSNP)对变异进行注释,解析其生物学意义。
文献案例
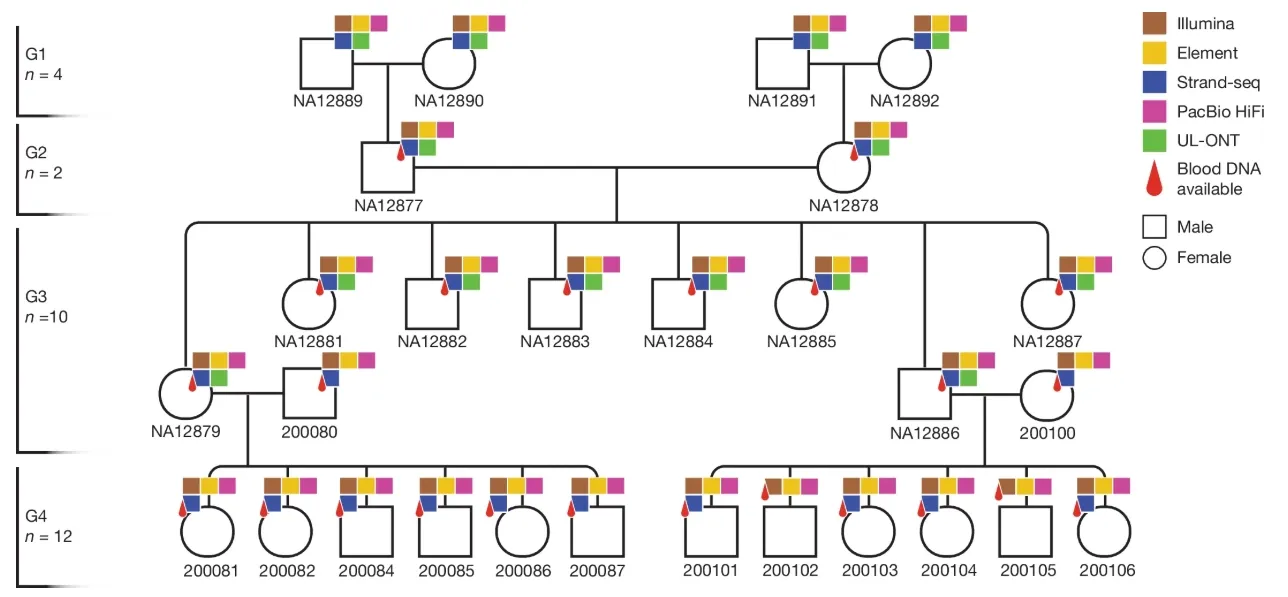
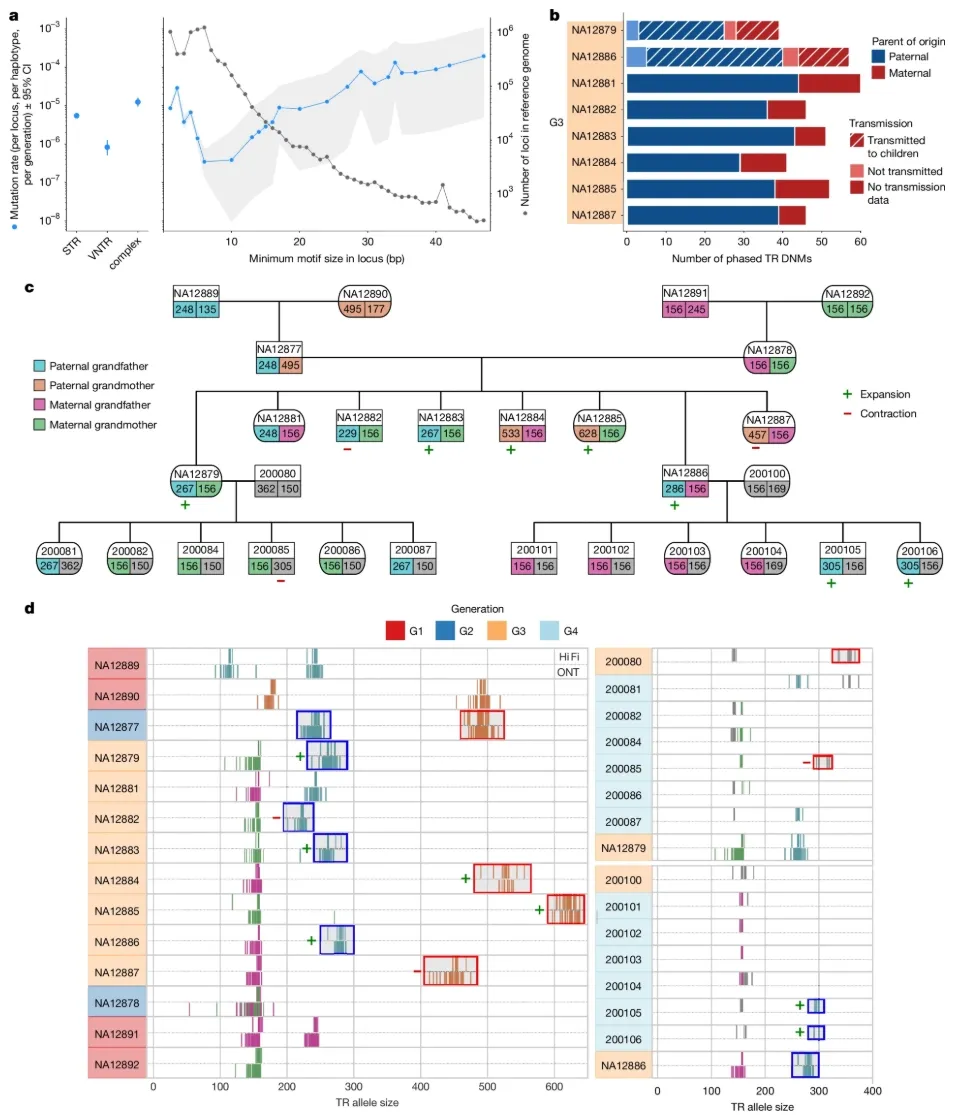
2025年4月23日,美国华盛顿大学作者发表在Nature期刊,题为《Human de novo mutation rates from a four-generation pedigree reference》的研究论文,文中利用四代家系(CEPH 1463)的WGS数据,首次绘制人类新生突变(DNM)全景图谱。该研究以四代28人家族(CEPH 1463)为对象,通过五种互补测序技术(PacBio HiFi、超长ONT、Strand-seq、Illumina、Element AVITI)结合长读长测序(LRS),实现了>95%基因组的高质量定相与组装(包括288个着丝粒、6条Y染色体),首次构建了“端粒到端粒(T2T)”的家族基因组资源。WGS的核心作用在于:突破技术局限,解析复杂区域,传统短读长测序(SRS)无法覆盖重复序列(如着丝粒、串联重复),而WGS通过长读长技术(如PacBio HiFi的15-20 kb reads)解决了这一问题,首次实现了这些“基因组暗物质”区域的完整组装。精确识别新生突变(DNM):WGS的高深度(平均>30×)和高连续性,使得研究人员能够准确检测单核苷酸变异(SNV)、插入缺失(Indel)、结构变异(SV)等多种突变类型,尤其是父系生殖系起源的突变(占75-81%)。构建高分辨率遗传图谱:结合WGS数据,研究团队绘制了3.4 kb断点分辨率的重组图谱,分析了减数分裂交叉与DNM的关联。通过WGS的全基因组覆盖,研究人员明确了串联重复序列(TR)是最易突变的区域(32个位点反复突变),且突变率与重复单元大小、基序长度显著相关。
实验流程
DNA 片段化
样品基因组DNA经浓度与完整性检测合格后,采用Covaris超声打断仪将长链DNA随机打断为300-500 bp片段,用于文库构建。
文库构建前处理
对打断后的双链DNA片段依次进行5′端磷酸化与3′端平滑的末端修复,并在3′端添加A尾,便于后续Y型接头的稳定连接与文库构建。
接头连接
将带唯一分子标签(index)的测序接头连接至加A尾的DNA片段两端,形成完整的初始DNA文库,为后续扩增与高通量测序做准备。
杂交捕获
使用Agilent SureSelect液相捕获探针与目标序列进行液相杂交,经严格洗脱富集特定区域,有效去除非目标背景序列干扰。
目标片段富集
利用链霉亲和素磁珠特异性吸附带有生物素标记的杂交探针-靶标复合物,经充分洗涤与洗脱富集,获取最终纯化的目标外显子序列用于后续扩增。
PCR 扩增
对捕获富集后的目标片段进行有限循环PCR扩增,引入完整的测序引物区与索引序列,获得产量、长度与复杂度均达标的最终测序文库,保障测序质量。
文库质检
采用Qubit定量、Agilent Bioanalyzer检测片段分布、qPCR测定有效浓度,综合评估文库质量是否达到上机标准要求。
上机测序
质检合格的文库经稀释与簇生成后,加载至Illumina标准测序平台进行高通量双端测序,产出合格的高质量原始下机数据,供下游分析。
测序参数
采用双端测序策略PE150(每端150 bp、合计读长300 bp),根据文库复杂度与项目需求设定合适的测序深度与数据量,保障数据质量。
送样标准
DNA样本、血液、组织、细胞系、FFPE样本等。
Genomic DNA
DNA总量≥0.2 μg(推荐0.4 μg)
DNA总量≥1 μg(推荐2 μg)
DNA总量≥50 ng
≥5×10~6cell
≥50mg
≥0.6 mL
≥ 10 片,未染色,100 mm2,5 ~ 10μm厚度
交付内容
比对结果
BAM/SAM文件,覆盖度及比对率统计。
变异检测
SNP/InDel/VCF文件,含等位基因频率、质量值及过滤结果。
功能注释
ANNOVAR注释结果,关联GO/KEGG通路。
可视化图表
染色体覆盖深度图、曼哈顿图、热图等。
分析报告
实验设计、质控参数、变异总结及生物学意义解读
常见问题
基因组可视化软件 IGV是高性能的基因组数据可视化工具,能够帮助使用者同时合并分析不同类型的基因组数据,并能灵活放大基因组上的某个特定区域。
可以使用“人基因组变异交互分析系统”进行后续变异位点筛选,寻找候选变异位点时,可利用变异注释结果,关注非同义突变、剪接突变、移码突变。
单基因遗传病的样本量一般是患者+非患病父母本(3例)或患者所在的三代以上的家系(十几例)左右。
复杂疾病样本量一般是患病样本+健康人群(几百例到上千例)或三代以上的大家系等。
