转录组学
精准捕捉基因表达动态,揭示调控机制,为您还原不同实验条件下基因的响应模式。
有参转录组
真核有参转录组(Eukaryotic Reference-Based Transcriptome, ERBT)是针对已有完整参考基因组的真核生物 ,通过高通量测序技术对细胞/组织中的mRNA(及非编码RNA,部分产品可拓展)进行系统性定量、差异分析与功能解析的核心技术。其核心优势在于依托已知参考基因组,无需进行转录本从头组装(de novo),直接通过序列比对实现精准的基因表达定量与变异检测,分析效率与结果可靠性远高于无参转录组。与真核无参转录组相比,ERBT具有三大核心价值:①定量精准:基于参考基因组的比对率通常≥95%,可实现基因/转录本水平的绝对/相对定量;②分析深度高:可挖掘可变剪切、SNP/InDel、基因融合等精细转录调控信息;③成本与周期可控:数据量需求低,分析周期缩短30%-50%。目前,ERBT已成为真核生物基础研究与应用开发的标配技术,广泛应用于疾病机制研究、动植物育种、药物研发等领域。
原理介绍
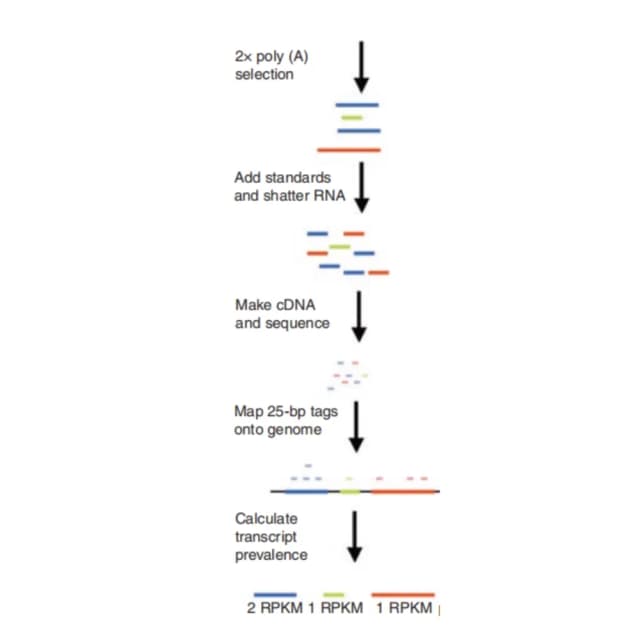
真核有参转录组的核心原理如下:样本处理与RNA提取,采用高纯度RNA富集策略:样本破碎;RNA提取;质量验证。链特异性文库构建:RNA片段化;逆转录;接头连接;UDG酶消化;PCR扩增。高通量测序,采用Illumina二代测序平台。数据分析与功能解析,数据过滤;序列比对;定量分析;差异分析;功能注释;高级分析。
文献案例
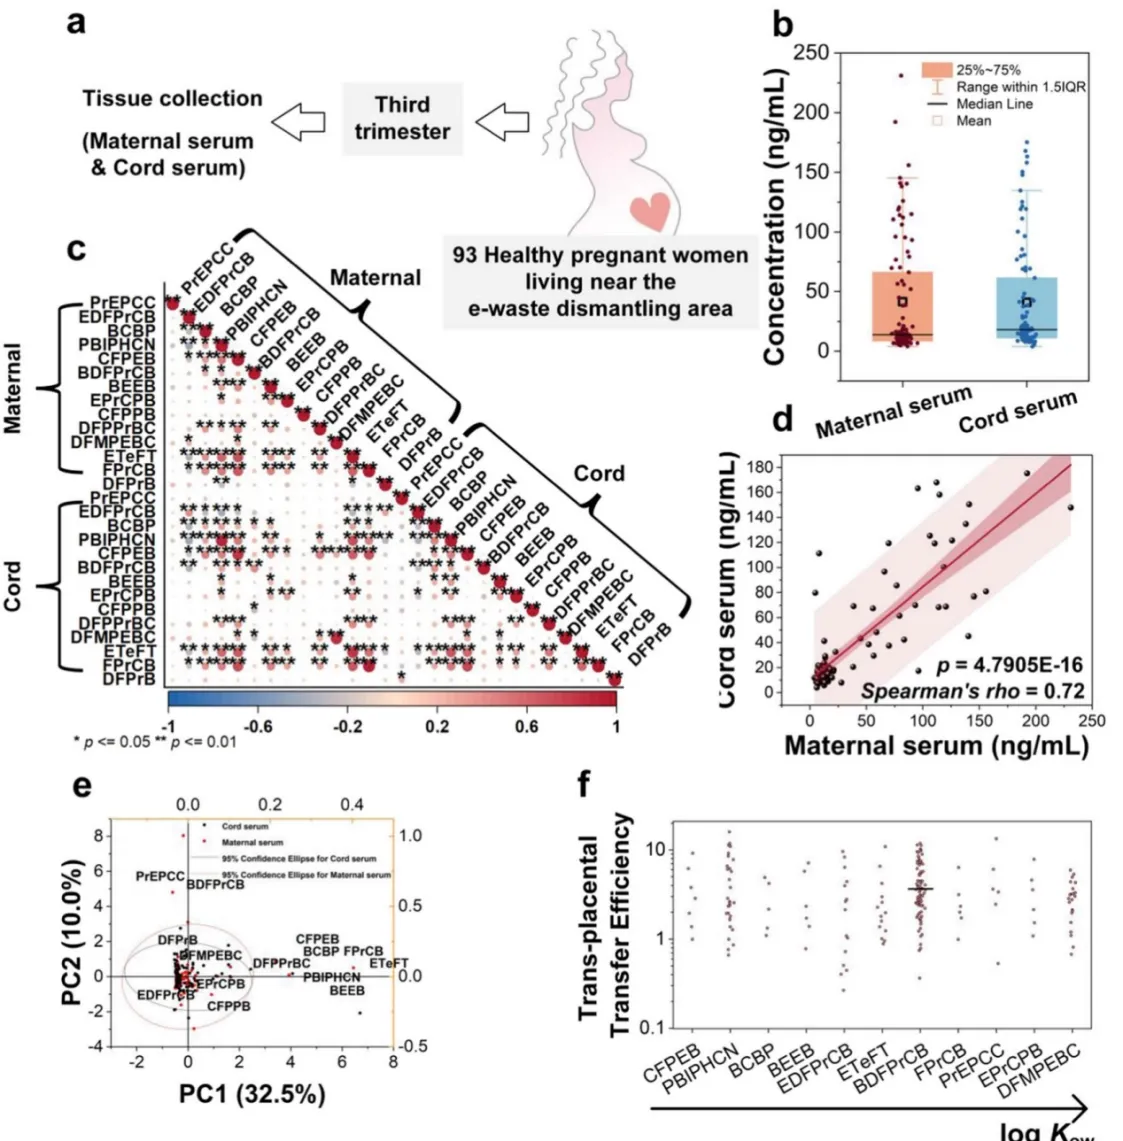
《Nature Communications》期刊上发表的"Liquid crystal monomers induce placental development and progesterone release dysregulation through transplacental transportation."探讨了液晶单体(LCMs)通过胎盘转运对胎盘发育和孕酮释放的影响。研究人员使用小鼠模型,结合真核有参转录组测序、蛋白质组学和代谢组学等多组学技术,系统分析了 LCMs 暴露后胎盘组织的基因表达变化、蛋白质水平改变和代谢物差异,揭示了 LCMs 导致胎盘功能障碍的分子机制,为评估环境污染物对生殖健康的风险提供了重要依据。通过真核有参转录组与小鼠参考基因组比对,全面鉴定 LCMs 暴露后胎盘组织中差异表达的基因,构建基因表达调控网络,明确 LCMs 影响胎盘发育的关键信号通路。
送样标准
动物组织≥30mg; 植物组织≥100mg;FFPE 5-10μm切片≥10张,组织面积≥20mm²;
贴壁细胞≥1×10⁶个;悬浮细胞≥2×10⁶个;细胞爬片≥5张;
血清/血浆≥5mL;脑脊液≥2mL、尿液≥10mL;唾液:≥3mL;
总量≥1μg(常规测序)、≥2μg(深度测序/高级分析)。
交付内容
数据质量控制报告
RNA质量评估:Nanodrop检测结果、Agilent 2100电泳图、RIN值报告;测序质量评估:有效数据量、Q30比例、参考基因组比对率、rRNA去除率,链特异性文库);文库质量评估:文库片段大小分布(200-500bp)、PCR重复率(≤15%)。
基因/转录本定量与注释结果
表达量矩阵:基因与转录本水平的FPKM/TPM定量数据,包含所有检测基因的名称、ID、表达值;差异分析结果:差异表达基因(DEG)列表(含log2FC、P值、FDR值)、火山图、热图、聚类分析图;数据库注释:基因功能注释表(关联GO、KEGG、Swiss-Prot、COG等数据库)、通路归属信息、基因序列信息。
高级分析结果
可变剪切分析:剪切类型、差异剪切事件列表;变异检测结果:SNP/InDel位点信息;基因共表达网络:WGCNA分析结果、转录因子-靶基因调控网络;个性化分析:如基因融合检测(肿瘤样本)、时间序列表达分析。
分析与解读报告
检测结论:核心差异基因集合、关键通路富集结果、潜在功能基因/标志物候选;结果解读:差异基因的生物学功能、调控机制、表达趋势分析;建议方案:后续验证方向、多组学联合分析建议。
常见问题
不建议直接测序,结果可靠性会显著下降。影响:RIN值≤6.0提示RNA严重降解,测序时短片段reads占比升高,参考基因组比对率会降至80%以下,低丰度基因检出率下降40%,差异基因筛选假阳性率升高。解决方案:若样本无法重新采集,可通过以下方式补救:a. 采用降解RNA专用文库构建试剂盒,提升短片段利用率;b. 提高测序深度至15G,补偿降解导致的信息丢失;c. 数据分析时过滤降解片段,但会损失部分信息。建议优先重新采集样本,确保RIN值≥6.8。
会影响注释准确性,优先选择最新版本,如人类hg38(2013年发布)比hg19(2009年发布)新增10%的基因注释,修正了大量序列错误,差异基因注释准确性提升20%;②匹配研究需求:若后续需与已有研究对比,可选择对应版本,但需注明版本差异;③特殊物种:选择物种专属数据库的最新版本,避免跨数据库注释偏差。各大公司均同步NCBI、Ensembl最新基因组版本,可要求服务商提供基因组版本明细。
核心通过实验设计+数据分析双重控制:①实验设计阶段:a. 统一样本处理流程;b. 同一测序平台、同批次文库构建;c. 插入质控样本。②数据分析阶段:a. 采用ComBat、SVA工具进行批次校正,通过PCA分析验证校正效果;b. 将批次作为协变量纳入差异分析模型;c. 严格筛选差异基因,降低批次干扰。
