单细胞组学
在单细胞分辨率下解析组织异质性,精准定义细胞亚群及其分化轨迹。
10X单细胞转录组
10x单细胞转录组技术是基于微流控系统与高通量测序的前沿组学技术,核心用于单个细胞水平的mRNA表达谱分析,可同时捕获数千至数万个细胞的基因表达信息,精准区分细胞亚群、解析细胞异质性及基因调控网络。相较于传统 bulk RNA-seq 技术,其打破了细胞群体平均化研究的局限,能捕捉到稀有细胞类型、动态细胞状态及细胞间的功能差异。 该技术已成为生物医学、肿瘤学、神经科学、发育生物学等领域的核心研究手段,广泛应用于肿瘤微环境解析、细胞分化轨迹重构、稀有细胞亚群鉴定、疾病机制探究及药物靶点筛选等场景。无论是基础科研中的细胞命运调控研究,还是临床中的疾病分型与精准治疗指导,10x单细胞转录组都能提供深度的分子层面证据,推动科研与临床向“单细胞分辨率”迈进。
原理介绍
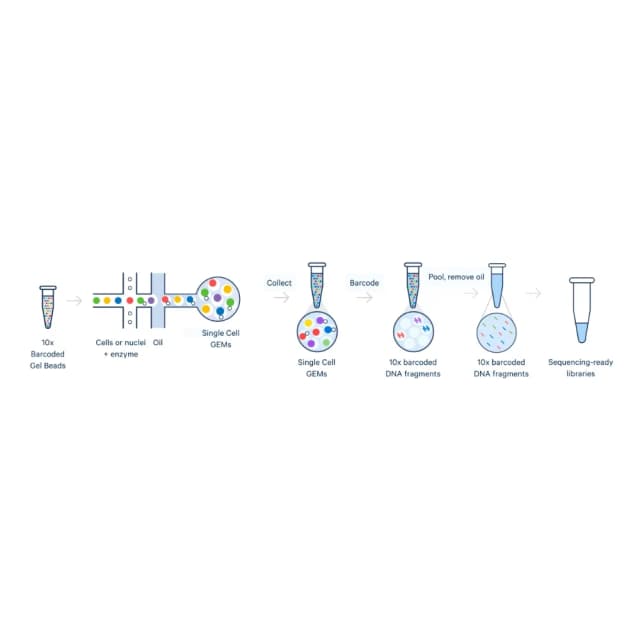
10x单细胞转录组技术核心基于“微流控捕获-单细胞标记-逆转录-高通量测序”的技术体系,依托独特的油包水微滴系统实现单个细胞的精准捕获与标记,核心原理如下: 通过微流控芯片将单个细胞、带有独特细胞 barcode 和分子 barcode 的凝胶珠(Gel Bead)及逆转录试剂包裹在同一油包水微滴中,确保每个微滴内仅含一个细胞和一个凝胶珠。凝胶珠溶解后释放 barcode 序列,在逆转录过程中,每个细胞的 mRNA 被逆转录为 cDNA,且每一条 cDNA 都带有专属的细胞 barcode 和分子 barcode。 后续通过 cDNA 扩增、文库构建与高通量测序,借助细胞 barcode 可将测序 reads 精准分配至对应的单个细胞,通过分子 barcode 可实现基因表达的绝对定量,最终获得每个细胞的基因表达谱,进而实现细胞亚群分类、异质性分析及基因调控网络解析。
文献案例
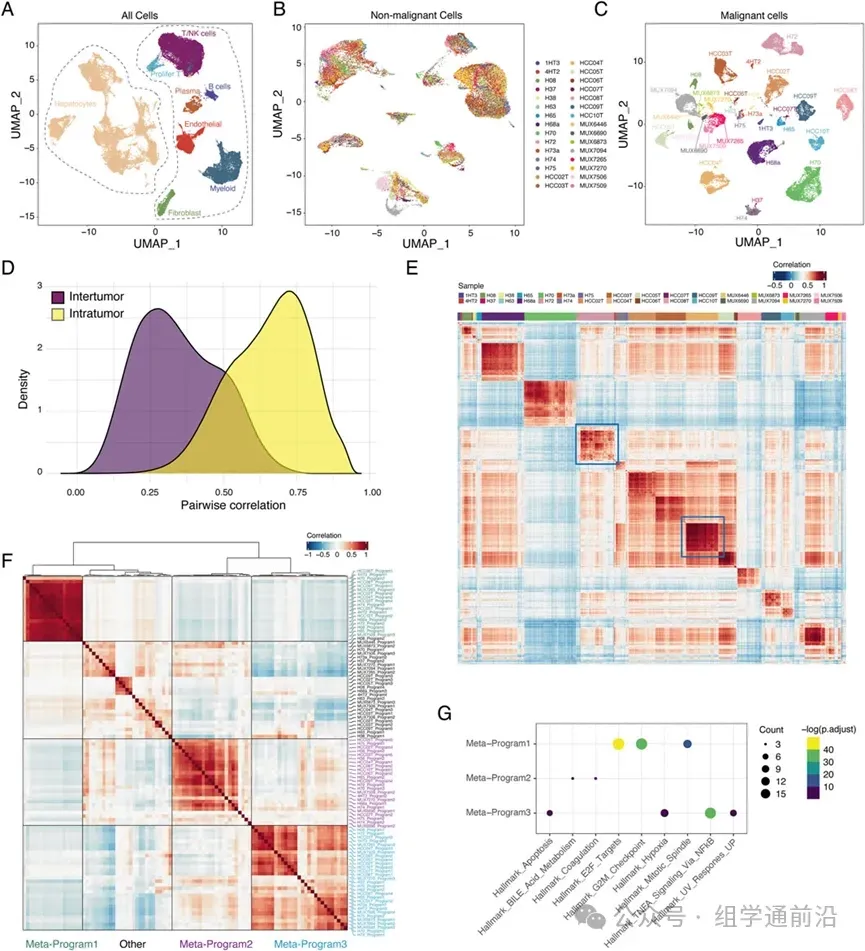
《Frontiers》发表题为“Single-cell transcriptomics reveals tumor microenvironment remodeling in hepatocellular carcinoma with varying tumor subclonal complexity”的研究,借助10x单细胞转录组技术,解析了不同亚克隆复杂性肝细胞癌(HCC)的肿瘤微环境重塑特征,为精准治疗提供依据。研究采集不同亚克隆复杂性的HCC肿瘤及癌旁组织,通过10x Genomics技术捕获测序数万单个细胞,解析肿瘤细胞、免疫细胞及基质细胞的表达谱差异。结果显示,高亚克隆复杂性HCC中,免疫抑制性细胞(如调节性T细胞、M2型巨噬细胞)浸润增加,同时基质细胞活化相关基因表达上调,形成促肿瘤微环境。
送样标准
重量≥0.1g/份,取材后立即置于组织保存液中,4°C冷藏运输(避免冷冻),24小时内送达;注明组织类型、部位、患者信息及处理条件,避免组织坏死或降解。
细胞浓度1×10⁵-1×10⁶个/mL,体积≥1mL/份,用无血清培养基重悬,添加0.04%牛血清白蛋白;4°C冷藏运输,避免震荡;确保细胞活性≥85%,无杂质、聚团及红细胞污染。
体积≥2mL/份,EDTA抗凝,4°C冷藏运输,6小时内送达;避免溶血,需注明采血时间、是否经过外周血单个核细胞(PBMC)分离。
细胞量≥1×10⁶个/份,消化为单细胞悬液后用无血清培养基重悬,4°C冷藏运输;注明细胞系名称、培养条件、处理方式(药物干预、诱导分化等),确保细胞活性达标。
细胞沉淀≥5×10⁶个/份,用冻存液冻存后液氮保存,干冰运输;解冻后需立即制备单细胞悬液,注明冻存时间及解冻方法,尽量降低细胞损伤。
交付内容
原始测序数据
包含Fastq格式原始测序 reads、测序质量控制报告(Q30值、GC含量、接头污染率等)、barcode分配统计数据。
数据分析报告
涵盖细胞过滤与聚类分析图、细胞亚群注释结果、差异表达基因分析(火山图、热图)、细胞轨迹分析、基因富集与调控网络分析及核心结论解读。
技术支持文档
提供单细胞悬液制备方案、文库构建参数、测序流程说明、数据分析流程代码及结果可视化指南,协助后续深入研究。
常见问题
①单细胞悬液制备不佳,存在细胞聚团,未完全解离为单个细胞;②微流控捕获时油包水微滴异常,导致多个细胞被包裹在同一微滴(双细胞/多细胞);③测序数据中barcode分配错误。解决方法:优化悬液制备流程,通过筛网过滤去除聚团;调整细胞浓度,降低双细胞捕获概率;数据分析时通过算法过滤双细胞数据,优化聚类参数。
①增加总细胞捕获量,提高稀有细胞被捕获的概率;②优化样品处理方式,避免稀有细胞丢失(如轻柔消化、低温离心);③采用细胞分选技术(如流式分选)预富集稀有细胞亚群后再进行测序;④选择高捕获效率的试剂与平台,确保低丰度细胞的有效捕获。
①结合已知细胞标志物基因(如CD4、CD8A标记T细胞,EPCAM标记上皮细胞)进行手动校正;②整合公共单细胞数据库(如Single Cell Atlas)的参考表达谱,辅助亚群注释;③优化聚类参数,调整分辨率,避免亚群过度拆分或合并;④结合多组学数据(如蛋白标志物)交叉验证注释结果。
